
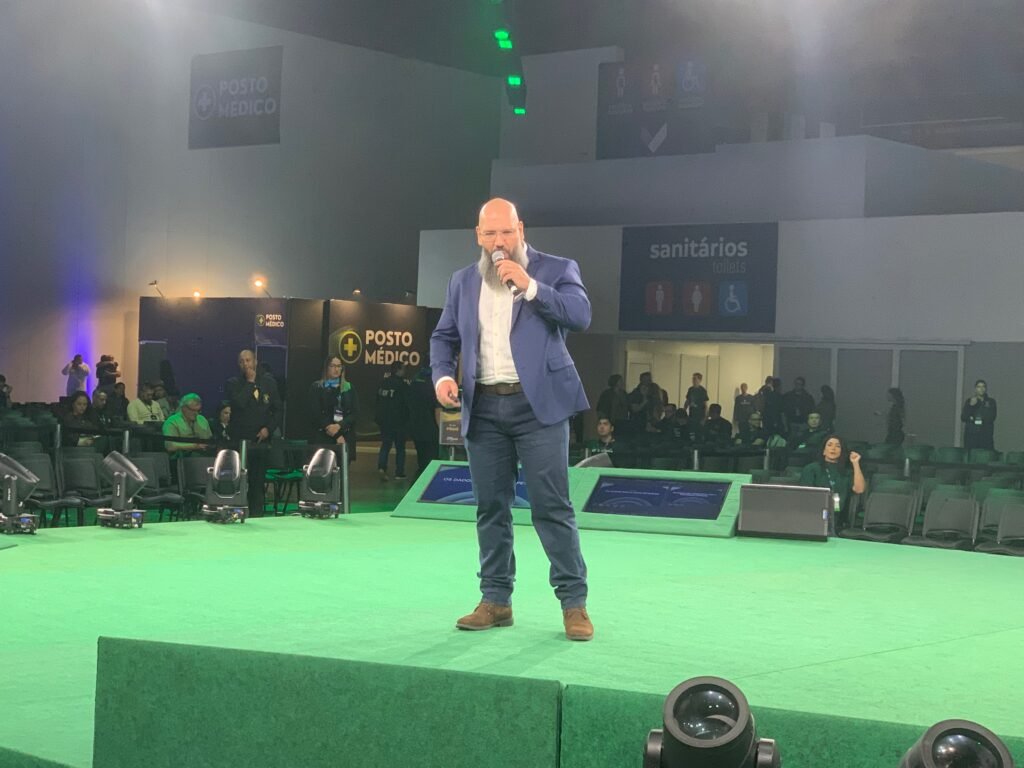
A inteligência artificial pode ter redes neurais avançadas, modelos fundacionais poderosos e capacidade para processar grandes volumes de informação. Mas, sem dados bem estruturados, os resultados ficam comprometidos. Essa foi uma das principais mensagens de Bruno Jardim, cofundador e CTO da PowerOfData, durante palestra no AI.Brasil Experience 2026.
Para explicar o que acontece por trás das ferramentas de IA, o executivo propôs uma mudança de perspectiva: em vez de apenas utilizar a tecnologia, é preciso entender como ela funciona e o que determina sua capacidade de gerar valor para as empresas. Mais do que discutir aplicações de inteligência artificial, Jardim explorou os mecanismos matemáticos e computacionais que permitem aos modelos aprender, interpretar informações e prever o próximo evento. A mensagem central foi que a qualidade dos dados continua sendo um dos fatores decisivos para transformar IA em resultado de negócio.
Dados de qualidade influenciam o resultado financeiro
A expressão “dados são o novo petróleo” já se tornou recorrente no mercado de tecnologia. Jardim, porém, levou a comparação para outro ponto: não basta acumular informações. É preciso saber processá-las e transformá-las em insumos úteis para os modelos de inteligência artificial.
“Os dados são o novo petróleo. O alimento, o combustível da inteligência artificial. Se a gente não tiver dados muito bem estruturados, a IA não vai funcionar”.
O desafio envolve empresas de diferentes setores, de bancos e seguradoras a organizações de varejo, saúde e telecomunicações. Em todos eles, o uso de IA precisa estar conectado a objetivos concretos, como aumentar o faturamento, reduzir custos e melhorar a fidelização de clientes.
Decisões melhores dependem de informações melhores e, quando a inteligência artificial consegue interpretar essas informações de forma adequada, as empresas têm mais condições de alcançar resultados financeiros positivos.
Por isso, a discussão sobre IA corporativa não deve ficar restrita à escolha de modelos ou ferramentas. Também precisa incluir a infraestrutura de dados, a forma como as informações são organizadas e a capacidade de preservar o contexto que dá significado a cada registro.
Como as redes neurais aprenderam a prever
Para explicar por que os dados são tão importantes, Jardim voltou às bases da inteligência artificial. Ele relembrou os primeiros estudos sobre modelos matemáticos inspirados no funcionamento dos neurônios biológicos e a evolução das técnicas que permitiram às máquinas identificar padrões.
O executivo abordou o perceptron, a regressão logística e a descida do gradiente, processo matemático utilizado para ajustar os parâmetros de uma rede neural e reduzir erros durante o treinamento. A partir da combinação de neurônios artificiais em diferentes camadas, os modelos passaram a lidar com problemas mais complexos, que não podem ser resolvidos por relações lineares simples.
Outro marco foi o desenvolvimento da retropropagação, conhecida como backpropagation, que permite ajustar os pesos da rede com base nos erros identificados durante o treinamento.
A evolução também passou pelas redes neurais recorrentes (RNNs), criadas para trabalhar com sequências de informações. Elas trouxeram a possibilidade de considerar o histórico de eventos, algo importante para compreender textos e outros dados sequenciais. Mas havia uma limitação: quanto maior a sequência, mais difícil poderia ser preservar informações relevantes que apareceram muito antes.
Jardim explicou esse problema por meio do chamado vanishing gradient, ou desaparecimento do gradiente. Durante o treinamento, os sinais usados para ajustar os parâmetros podem ficar tão pequenos que a rede perde a capacidade de aprender relações importantes em sequências longas.
As redes LSTM, desenvolvidas para preservar informações por períodos maiores, ajudaram a reduzir essa limitação. Ainda assim, históricos extensos e relações distantes continuavam impondo dificuldades.
Transformers mudaram a forma de interpretar o contexto
A chegada dos transformers, em 2017, representou outro avanço. A arquitetura apresentada por pesquisadores do Google introduziu o mecanismo de self-attention, que permite ao modelo avaliar as relações entre diferentes partes de uma sequência e identificar quais informações são mais relevantes para interpretar cada elemento.
Em vez de depender apenas de uma memória sequencial, o modelo consegue relacionar palavras e informações distribuídas pelo texto. Isso ampliou a capacidade de processar dependências de longo alcance e abriu caminho para os grandes modelos de linguagem, conhecidos como LLMs.
Jardim também explicou que o processamento de texto começa com a tokenização, etapa que divide o conteúdo em unidades menores. Essas unidades são convertidas em representações numéricas, que permitem ao modelo trabalhar matematicamente com as informações.
Os embeddings são parte importante desse processo. Eles representam tokens e outros elementos em espaços matemáticos nos quais relações e semelhanças podem ser aprendidas. Combinados ao contexto, ajudam o modelo a estimar quais tokens devem aparecer em seguida. Durante o treinamento, o modelo aprende padrões a partir de grandes volumes de dados e utiliza esses padrões para prever o próximo token ou evento. Nos modelos fundacionais, esse aprendizado pode ocorrer sem a necessidade de rótulos explícitos para cada exemplo.
O ponto destacado pelo CTO é que a capacidade de previsão depende daquilo que o modelo consegue aprender a partir das informações disponíveis. Uma arquitetura avançada não compensa automaticamente dados que perderam relações importantes durante a organização ou o processamento.
O problema está no que os dados deixam de mostrar
Na palestra, Jardim chamou a atenção para uma questão que pode passar despercebida em projetos de IA: a agregação e a simplificação dos dados podem eliminar informações essenciais para a compreensão de um evento.
A ordem em que as coisas aconteceram, a frequência com que determinado comportamento se repete e a combinação de diferentes sinais ajudam a construir o contexto. Quando essas características desaparecem, o modelo pode receber informações corretas isoladamente, mas sem elementos suficientes para interpretar o que realmente ocorreu.
Esse desafio ganha importância em aplicações empresariais que dependem de históricos, recorrências e relações entre eventos. A discussão sobre a qualidade dos dados precisa ir além da precisão de campos e registros. Também deve considerar se as representações utilizadas preservam as relações temporais e contextuais necessárias para que a IA produza previsões úteis.
A janela de contexto também influencia a resposta
Outro ponto importante é a escolha das informações que entram na janela de contexto de um modelo. Mesmo quando uma empresa possui um grande volume de dados, nem tudo será necessariamente apresentado ao modelo em cada interação.
A seleção do conteúdo influencia quais relações poderão ser identificadas e quais elementos servirão de base para a resposta. Na prática, definir o que o modelo vai ler também significa definir quais partes da história estarão disponíveis para orientar sua interpretação.
Isso coloca a engenharia e a preparação dos dados no centro das iniciativas de IA generativa. Não basta conectar uma empresa a um modelo fundacional e esperar que ele compreenda automaticamente todos os detalhes de suas operações. É necessário estruturar as informações de maneira que os aspectos relevantes permaneçam acessíveis.
Há implicações para projetos de IA corporativa, incluindo assistentes internos, sistemas de recomendação, análise de comportamento e aplicações que precisam interpretar históricos complexos. Em todos esses casos, preservar relações entre dados pode ser tão importante quanto ampliar o volume de informações processadas. “O dado não mudou, mudou a maneira de representá-lo”, complementou Jardim.
Sem comentários registrados